
Ein Brand im Serverraum, ein Wasserschaden, ein Ransomware-Angriff, der Ausfall des Rechenzentrums beim Dienstleister: Irgendwann fällt die IT aus, die Frage ist nur, wie lange. Disaster Recovery beschreibt alles, was nötig ist, damit diese Zeit kurz bleibt und der Betrieb nach einem schweren IT-Ausfall geordnet wieder anläuft.
Dieser Beitrag erklärt, was Disaster Recovery bedeutet, wie es sich von Backup und Business Continuity unterscheidet, welche Strategien es gibt, wie ein Plan entsteht und wie Sie prüfen, ob er im Ernstfall funktioniert. Wie Sie Datensicherung und Wiederherstellung technisch konkret umsetzen, zeigt unser Beitrag Backup und Disaster Recovery richtig umsetzen.
Was ist Disaster Recovery?
Disaster Recovery, auf Deutsch IT-Notfallwiederherstellung, umfasst die Strategien, Pläne und technischen Vorkehrungen, mit denen ein Unternehmen nach einem schwerwiegenden Ausfall seine IT-Systeme, Anwendungen und Daten wiederherstellt. Ziel ist, die geschäftskritischen Systeme innerhalb einer festgelegten Zeit und mit einem festgelegten maximalen Datenverlust wieder bereitzustellen.
Disaster Recovery betrifft nicht nur Server und Daten, sondern alles, was für den Betrieb nötig ist: Netzwerk, Verzeichnisdienst, Internetanbindung, Arbeitsplätze, Zugangsdaten, Lizenzen und die Menschen, die wissen, was zu tun ist.
Typische Auslöser
- Cyberangriffe, vor allem Ransomware
- Hardwaredefekte an zentralen Systemen
- Brand, Wasser, Stromausfall
- Ausfall eines Rechenzentrums oder Cloud-Anbieters
- schwerwiegende Bedienfehler, etwa versehentlich gelöschte Systeme
- fehlgeschlagene Updates oder Migrationen
Disaster Recovery, Backup und Business Continuity
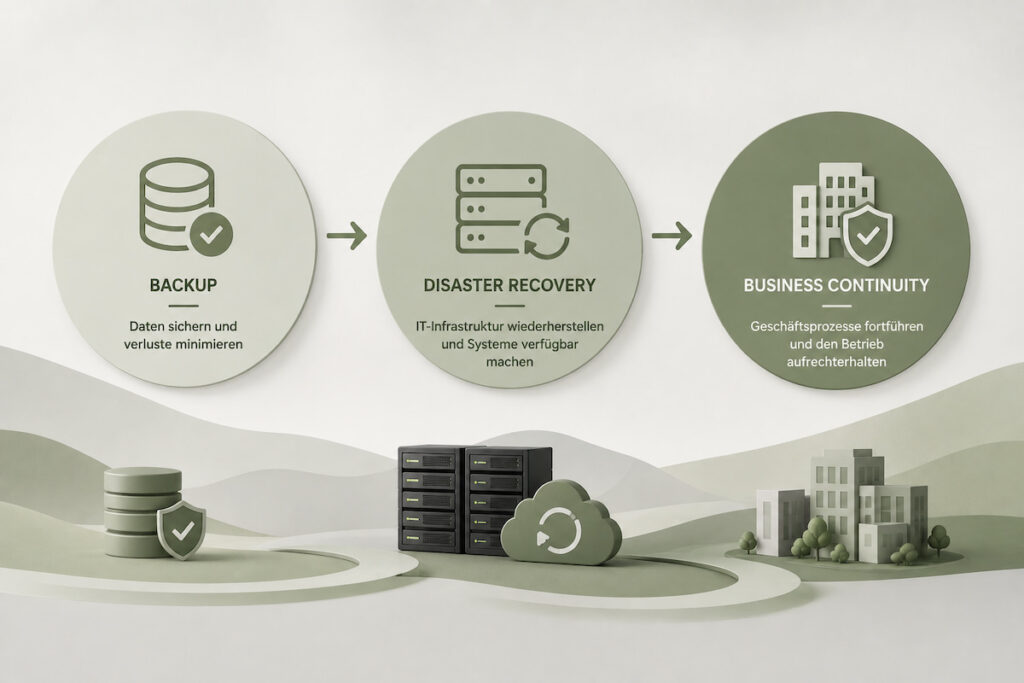
Die drei Begriffe werden oft vermischt, beschreiben aber unterschiedliche Ebenen:
| Begriff | Frage | Umfang |
|---|---|---|
| Backup | Sind die Daten gesichert? | Kopien von Daten und Systemen |
| Disaster Recovery | Wie bekommen wir die IT nach einem Ausfall wieder zum Laufen? | Wiederherstellung von Systemen, Anwendungen und Daten nach Plan |
| Business Continuity Management | Wie läuft das Geschäft weiter, auch wenn die IT, ein Standort oder Personal ausfällt? | gesamte Organisation, einschließlich Notbetrieb, Krisenstab und Kommunikation |
Ein Backup ist also die Voraussetzung für Disaster Recovery, aber nicht dasselbe. Wer eine Sicherung hat, aber nicht weiß, in welcher Reihenfolge Systeme wiederhergestellt werden, wer entscheidet und wie lange es dauert, hat kein Disaster Recovery. Und Disaster Recovery ist wiederum ein Teil des Business Continuity Managements, das auch Fragen jenseits der IT beantwortet.
Cyber Recovery: Disaster Recovery nach einem Angriff
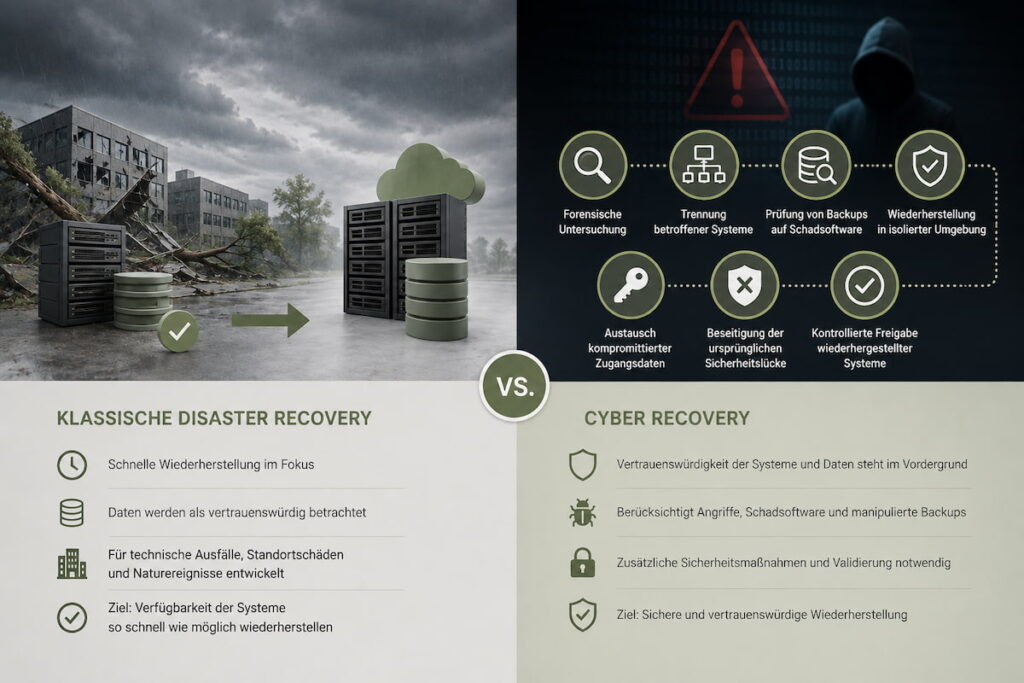
Klassische Disaster-Recovery-Konzepte gehen von einem technischen Ausfall aus: Ein System ist kaputt, man schaltet auf ein anderes um. Bei einem Cyberangriff ist die Lage anders. Die Täter waren möglicherweise wochenlang im Netz, haben Hintertüren hinterlassen und gezielt Backups angegriffen. Eine Ersatzumgebung, die automatisch alle Daten spiegelt, ist dann ebenfalls verschlüsselt. Cyber Recovery ergänzt Disaster Recovery deshalb um isolierte, unveränderbare Sicherungen, eine saubere Wiederaufbauumgebung und die Prüfung jedes Systems auf Spuren des Angreifers, bevor es zurück ins Netz geht.
RTO und RPO: die Zielwerte
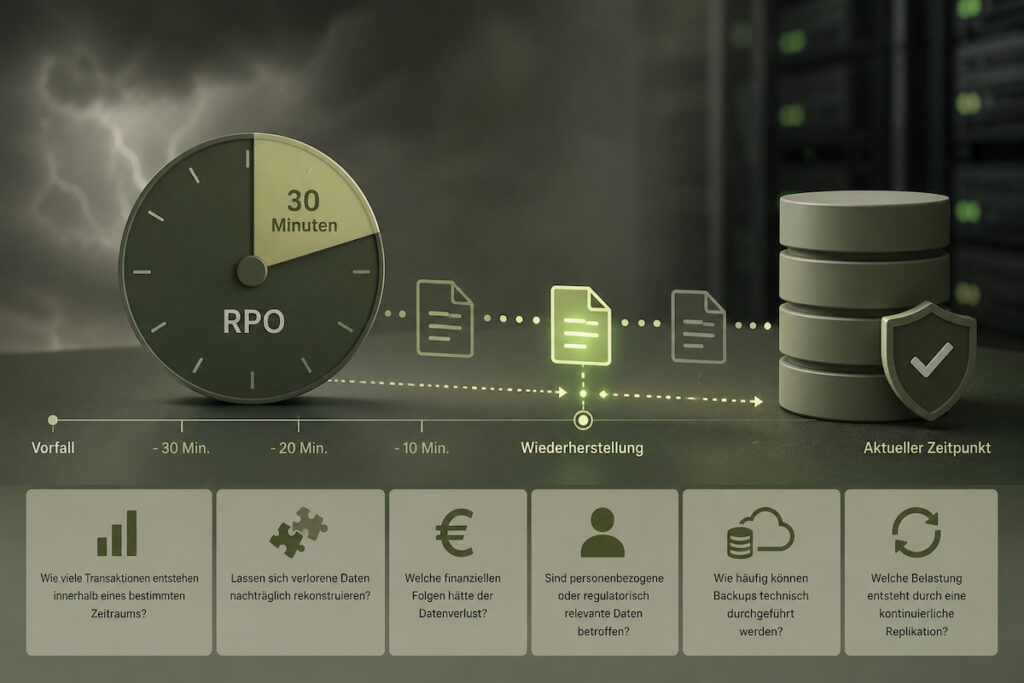
Jede Disaster-Recovery-Planung beginnt mit zwei Zahlen pro System:
- Recovery Time Objective (RTO): Wie lange darf das System höchstens ausfallen, bis es wieder läuft?
- Recovery Point Objective (RPO): Wie viele Daten dürfen höchstens verloren gehen, gemessen als Zeitraum vor dem Ausfall?
Ein RTO von vier Stunden und ein RPO von einer Stunde für das ERP-System bedeuten: Nach spätestens vier Stunden muss es wieder laufen, und es darf höchstens die letzte Stunde an Buchungen fehlen. Je kleiner die Werte, desto aufwendiger und teurer die Technik. Deshalb werden sie nicht pauschal festgelegt, sondern aus der Bedeutung des Systems für das Geschäft abgeleitet.
Business Impact Analysis: Was ist wirklich kritisch?
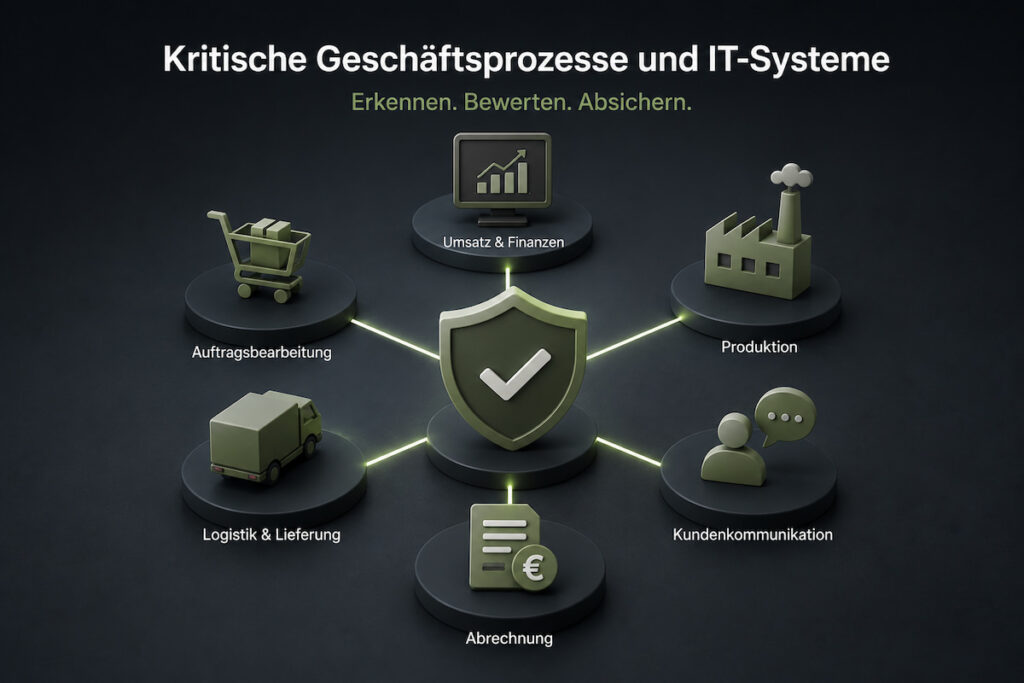
Welche Systeme welches RTO und RPO brauchen, ergibt sich aus der Business Impact Analysis. Sie beantwortet für jeden wichtigen Geschäftsprozess:
- Was passiert, wenn der Prozess eine Stunde, einen Tag, eine Woche ausfällt? Umsatzverlust, Vertragsstrafen, rechtliche Folgen, Reputationsschaden?
- Ab wann wird der Ausfall existenzbedrohend?
- Welche IT-Systeme, Daten und Dienstleister braucht der Prozess?
- Welche Abhängigkeiten bestehen zwischen den Systemen?
Die Abhängigkeiten werden oft unterschätzt. Das ERP-System nützt nichts, wenn der Verzeichnisdienst für die Anmeldung fehlt, die Datenbank auf einem anderen Server läuft oder die Lizenzprüfung eine Internetverbindung braucht. Eine dokumentierte Abhängigkeitskarte legt die Reihenfolge der Wiederherstellung fest.
| Kategorie | Beispiel | Typisches RTO |
|---|---|---|
| Kritisch | Verzeichnisdienst, ERP, Produktionssteuerung, Onlineshop | Stunden |
| Wichtig | E-Mail, Dateiserver, CRM | ein Arbeitstag |
| Unterstützend | Intranet, Archiv, Testsysteme | mehrere Tage |
Disaster-Recovery-Strategien im Vergleich
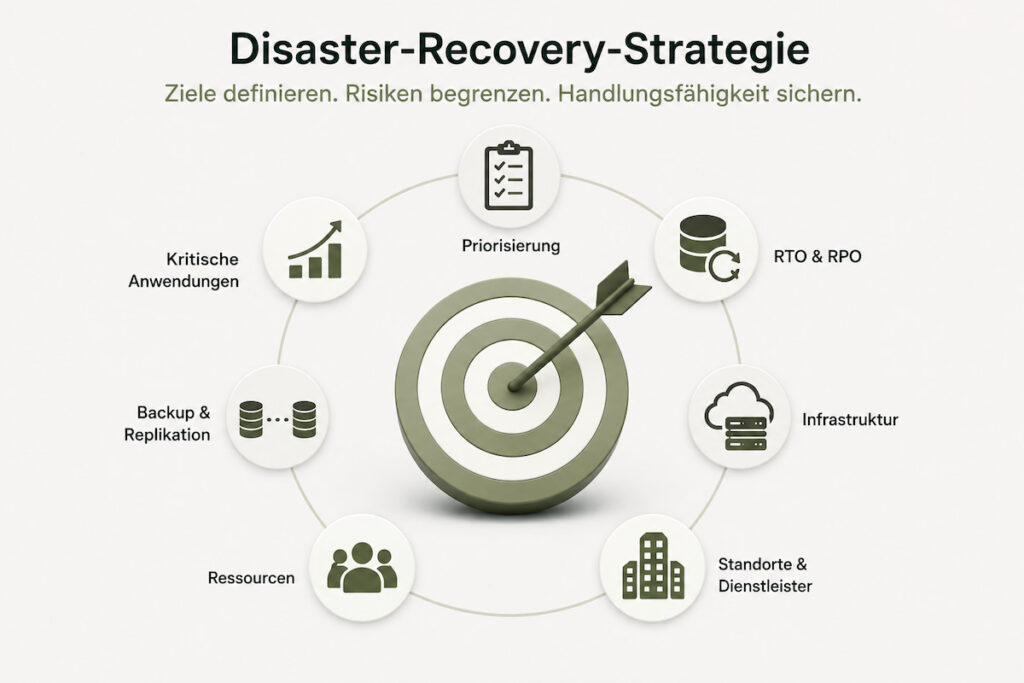
Wie schnell eine Wiederherstellung gelingt, hängt von der gewählten Strategie ab. Die gängigen Ansätze unterscheiden sich vor allem darin, wie viel Ersatzinfrastruktur dauerhaft bereitsteht:
| Strategie | Funktionsweise | Erreichbare Wiederherstellungszeit | Aufwand |
|---|---|---|---|
| Wiederherstellung aus Backup | Systeme werden im Ernstfall neu aufgesetzt und aus der Sicherung befüllt | Tage | gering |
| Cold Site | Ausweichstandort mit Strom und Netz, Hardware muss erst beschafft oder eingerichtet werden | Tage bis Wochen | gering bis mittel |
| Warm Site | Ausweichumgebung mit vorbereiteter Hardware, Daten werden regelmäßig übertragen | Stunden bis ein Tag | mittel |
| Hot Site | vollständige Ersatzumgebung, Daten laufend gespiegelt | Minuten bis Stunden | hoch |
| Aktiv-aktiv | zwei Umgebungen arbeiten parallel, fällt eine aus, übernimmt die andere | nahezu unterbrechungsfrei | sehr hoch |
In der Praxis kombinieren mittelständische Unternehmen mehrere Strategien: eine schnelle Ersatzlösung für die wenigen kritischen Systeme, die einfache Wiederherstellung aus Backups für den Rest.
Disaster Recovery in der Cloud und als Service
Cloud-Plattformen haben Ersatzumgebungen deutlich günstiger gemacht. Statt eines zweiten Rechenzentrums werden Systeme in die Cloud repliziert und erst im Ernstfall vollständig gestartet. Bei Disaster Recovery as a Service übernimmt ein Dienstleister Replikation, Überwachung und Tests. Achten Sie bei der Auswahl auf vertraglich zugesicherte Wiederherstellungszeiten, Rechenzentren in der EU, regelmäßige gemeinsame Tests und den Schutz der replizierten Daten vor Ransomware. Wichtig: Auch Cloud-Dienste wie Microsoft 365 brauchen ein eigenes Backup, der Anbieter garantiert die Verfügbarkeit des Dienstes, nicht die Wiederherstellbarkeit Ihrer Daten.
Failover und Failback
Der Failover ist das Umschalten auf die Ersatzumgebung, der Failback die Rückkehr zum Primärsystem, wenn es wieder bereit ist. Beides muss geplant und geübt sein. Gerade der Failback wird oft vergessen: Daten, die während des Notbetriebs entstanden sind, müssen sauber zurückgeführt werden, ohne Doppelungen oder Verluste.
Was in den Disaster-Recovery-Plan gehört
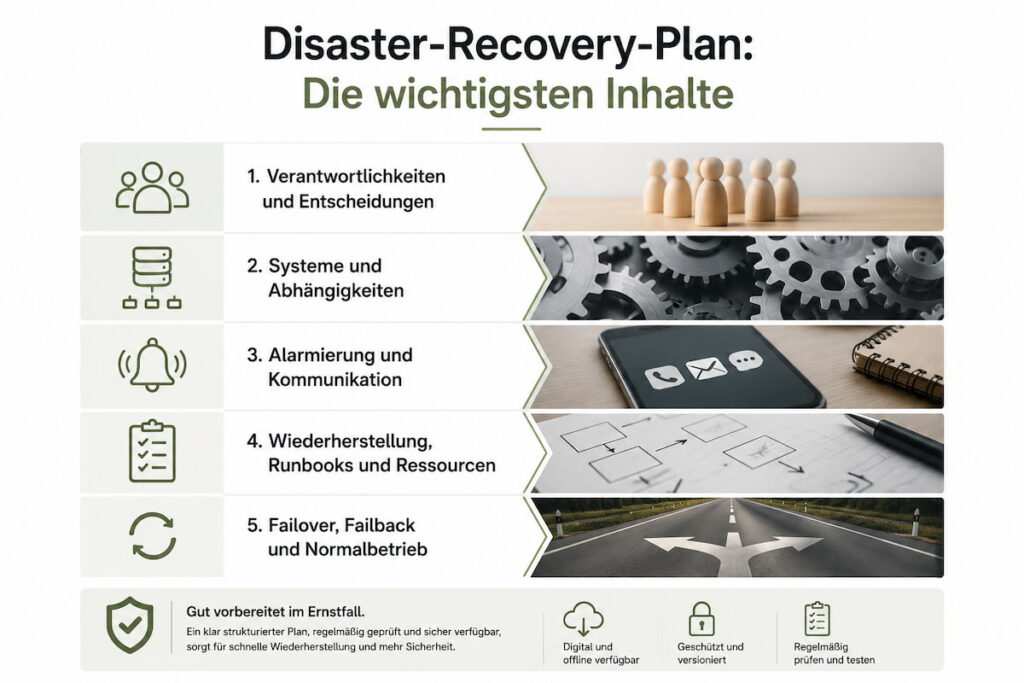
Der Plan ist das Handbuch für den Ernstfall. Er muss so geschrieben sein, dass ihn auch jemand umsetzen kann, der unter Stress steht oder die Systeme nicht täglich betreut. Diese Bestandteile gehören hinein:
- Auslöser und Entscheidung: Wann wird der Plan aktiviert, und wer darf das entscheiden?
- Rollen und Kontakte: Krisenstab, technische Verantwortliche, Vertretungen, Dienstleister, Versicherung, Behörden, mit Telefonnummern, die auch ohne E-Mail erreichbar sind.
- Systemübersicht: kritische Systeme mit RTO, RPO und Abhängigkeiten.
- Wiederherstellungsreihenfolge: was zuerst, was danach.
- Runbooks: konkrete Schritt-für-Schritt-Anleitungen für die Wiederherstellung jedes kritischen Systems.
- Zugänge: wo Notfallkonten, Passwörter und Lizenzschlüssel sicher hinterlegt sind.
- Kommunikation: wer Beschäftigte, Kunden und Partner informiert, mit Vorlagen.
- Rückkehr zum Normalbetrieb: Kriterien für den Failback und die Nachbereitung.
Der Plan muss auch dann verfügbar sein, wenn die IT ausgefallen ist. Eine ausgedruckte Fassung und eine Kopie außerhalb der eigenen Systeme sind Pflicht.
Einen Disaster-Recovery-Plan erstellen
- Geschäftsprozesse und Systeme erfassen und mit der Business Impact Analysis bewerten.
- RTO und RPO festlegen, gemeinsam mit der Geschäftsführung, nicht allein in der IT.
- Risiken und Szenarien beschreiben: Ransomware, Hardwareausfall, Standortverlust, Ausfall des Dienstleisters.
- Strategie je System wählen, passend zu RTO, RPO und Budget.
- Technik umsetzen: Backups, Replikation, Ersatzumgebung, isolierte Sicherungen.
- Plan und Runbooks schreiben und an die Verantwortlichen verteilen.
- Testen, verbessern, wiederholen.
Disaster Recovery testen
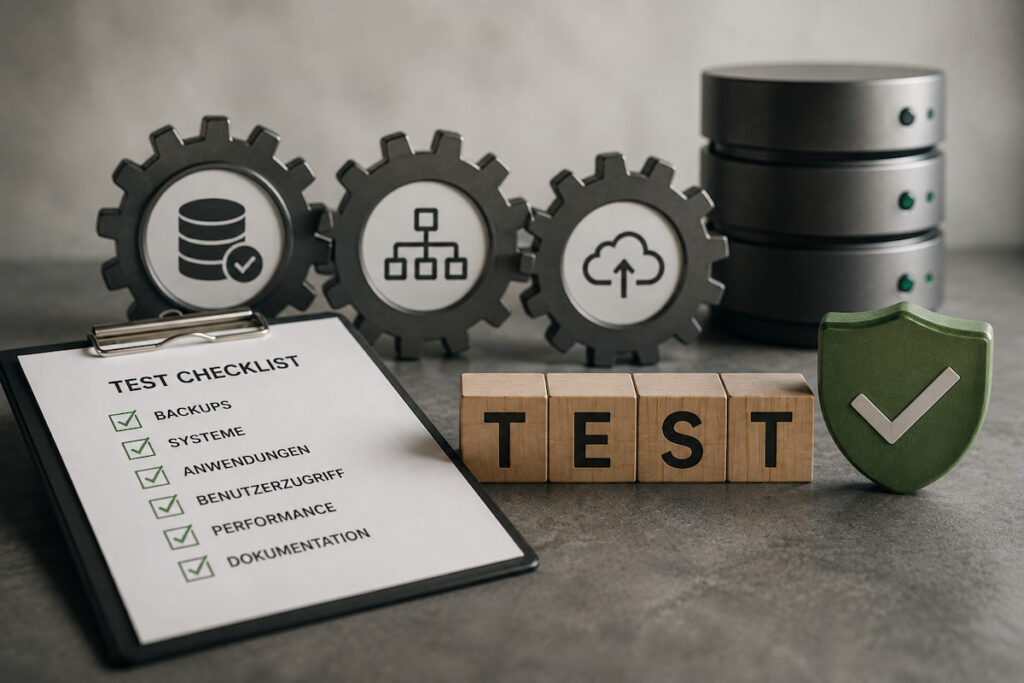
Ein ungetesteter Plan ist eine Vermutung. Bewährt haben sich drei Testarten mit zunehmendem Aufwand:
| Testart | Was passiert | Empfohlene Häufigkeit |
|---|---|---|
| Planbesprechung | Die Beteiligten gehen den Plan gemeinsam am Tisch durch und spielen ein Szenario theoretisch durch. | mindestens jährlich |
| Teilweise Wiederherstellung | Einzelne Systeme werden tatsächlich aus der Sicherung oder in der Ersatzumgebung wiederhergestellt. | für kritische Systeme mehrmals im Jahr |
| Vollständiger Test | Ein realistisches Szenario wird durchgespielt, einschließlich Failover, Notbetrieb und Failback. | jährlich oder nach größeren Änderungen |
Messen Sie bei jedem Test, ob die vereinbarten Wiederherstellungszeiten tatsächlich erreicht wurden, und halten Sie fest, was nicht funktioniert hat. Typische Erkenntnisse: fehlende Passwörter, veraltete Dokumentation, vergessene Abhängigkeiten. Jede davon ist im Test billiger zu beheben als im Ernstfall.
Was Standards und Gesetze verlangen
- BSI-Standard 200-4: Der BSI-Standard 200-4 Business Continuity Management beschreibt den Aufbau eines Notfallmanagements in drei Stufen: Reaktiv-BCMS als einfacher Einstieg mit Schwerpunkt auf der Notfallbewältigung, Aufbau-BCMS mit schrittweise erweitertem Geltungsbereich und Standard-BCMS, das den Anforderungen der ISO 22301 entspricht.
- NIS2: Für betroffene Unternehmen nennt § 30 Abs. 2 Nr. 3 BSI-Gesetz ausdrücklich die Aufrechterhaltung des Betriebs, Backup-Management, Wiederherstellung nach einem Notfall und Krisenmanagement.
- DSGVO: Art. 32 verlangt die Fähigkeit, die Verfügbarkeit personenbezogener Daten und den Zugang zu ihnen bei einem Zwischenfall rasch wiederherzustellen.
- ISO 27001 und ISO 22301: Beide Normen fordern geplante und geprüfte Vorkehrungen für die Kontinuität bei Störungen.
Was Disaster Recovery kostet
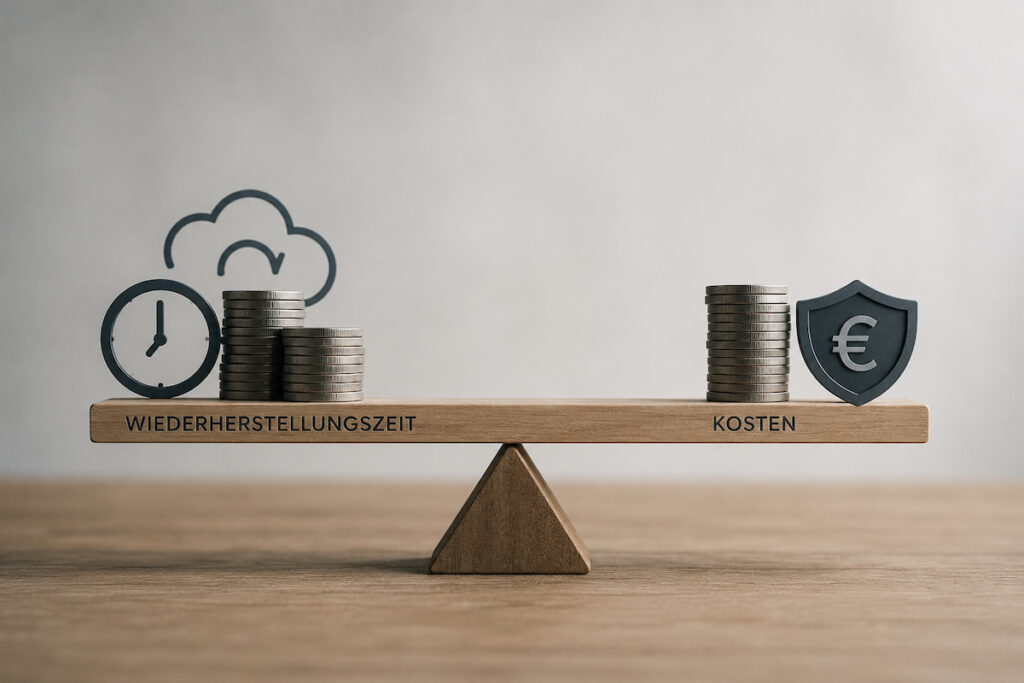
Die Kosten hängen vor allem von den Zielwerten ab. Ein RTO von Tagen lässt sich mit guten Backups und einem dokumentierten Wiederaufbau erreichen. Ein RTO von Minuten braucht eine dauerhaft laufende Ersatzumgebung. Für eine fundierte Entscheidung stellen Sie die Kosten der Lösung den Kosten eines Ausfalls gegenüber: Umsatzausfall pro Tag, Lohnkosten für Beschäftigte ohne Arbeit, Vertragsstrafen, Wiederherstellungsaufwand und Vertrauensverlust. Für die meisten mittelständischen Unternehmen liegt die wirtschaftliche Lösung in einer Abstufung: hohe Verfügbarkeit für wenige kritische Systeme, einfache Wiederherstellung für alles andere.
Praxisbeispiel: Ransomware legt das ERP-System lahm
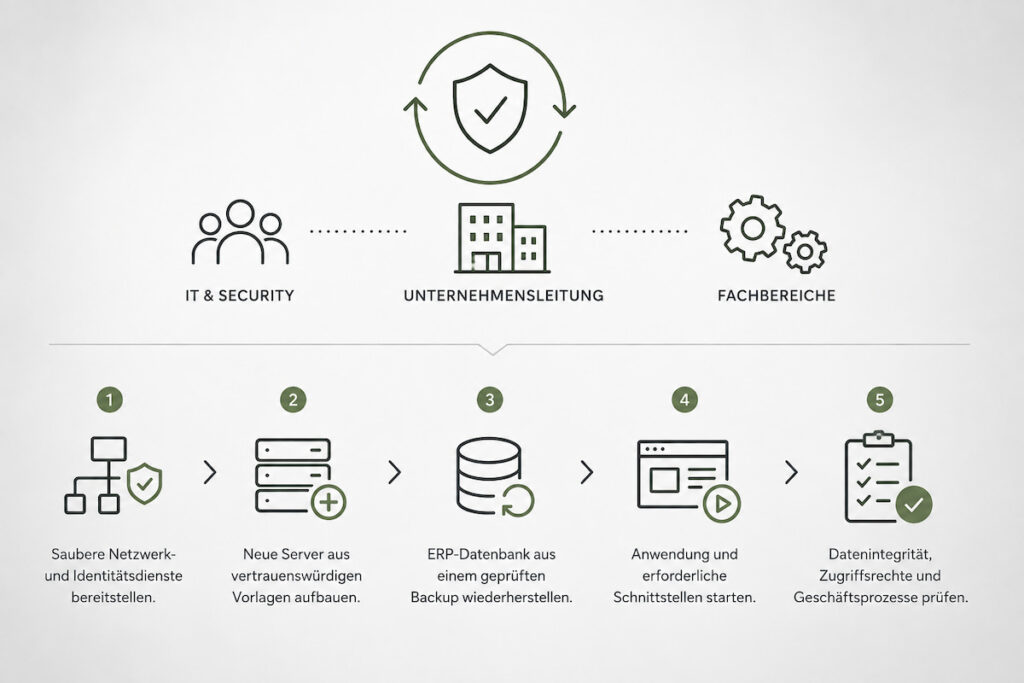
Ein Großhändler mit 120 Beschäftigten wird an einem Dienstagmorgen Opfer eines Ransomware-Angriffs. ERP-System, Dateiserver und Verzeichnisdienst sind verschlüsselt. Der Disaster-Recovery-Plan legt für das ERP-System ein RTO von 24 Stunden und ein RPO von vier Stunden fest.
- Stunde 0 bis 2: Der Krisenstab aktiviert den Plan, das Netz wird getrennt, der Incident-Response-Partner übernimmt die Analyse.
- Stunde 2 bis 8: In einer isolierten, sauberen Umgebung wird zuerst der Verzeichnisdienst aus einer unveränderbaren Sicherung wiederhergestellt und auf Spuren der Täter geprüft.
- Stunde 8 bis 20: Datenbank und ERP-System folgen in der festgelegten Reihenfolge. Der Vertrieb arbeitet derweil mit vorbereiteten Notfallformularen.
- Stunde 22: Das ERP-System läuft wieder, Buchungen der letzten drei Stunden vor dem Angriff werden nacherfasst.
Die Zielwerte wurden eingehalten, weil Reihenfolge, Zuständigkeiten und Zugänge vorher feststanden und die Wiederherstellung zwei Monate zuvor geübt worden war.
Wer für Disaster Recovery verantwortlich ist
Disaster Recovery ist keine reine IT-Aufgabe. Ohne klare Rollen scheitert auch der beste technische Plan:
| Rolle | Aufgabe |
|---|---|
| Geschäftsführung | legt Zielwerte und Budget fest, entscheidet im Ernstfall über die Aktivierung des Plans und über Notbetrieb |
| Notfallbeauftragte oder IT-Leitung | verantwortet Plan, Tests und Aktualisierung, koordiniert die Wiederherstellung |
| Fachbereiche | bewerten in der Business Impact Analysis, was ein Ausfall kostet, und bereiten den Notbetrieb vor |
| Technische Verantwortliche | pflegen Runbooks und führen die Wiederherstellung durch, jeweils mit benannter Vertretung |
| Dienstleister | erbringen vertraglich zugesicherte Leistungen, etwa Ersatzumgebung oder Unterstützung rund um die Uhr |
Prüfen Sie besonders die Vertretungen. Fällt die einzige Person aus, die das Backup-System bedienen kann, steht die Wiederherstellung, egal wie gut die Technik ist.
Checkliste: Ist Ihr Unternehmen vorbereitet?
- Für jedes geschäftskritische System sind RTO und RPO festgelegt und von der Geschäftsführung bestätigt.
- Abhängigkeiten zwischen den Systemen sind dokumentiert, die Wiederherstellungsreihenfolge steht fest.
- Mindestens eine Sicherung ist offline oder unveränderbar und vor Angreifern geschützt.
- Für die kritischen Systeme gibt es Schritt-für-Schritt-Anleitungen zur Wiederherstellung.
- Notfallkonten, Passwörter und Lizenzschlüssel sind sicher hinterlegt und im Ernstfall erreichbar.
- Der Plan liegt ausgedruckt und außerhalb der eigenen IT vor.
- Rollen und Vertretungen sind benannt, Kontaktdaten aktuell.
- Ein Notbetrieb für die wichtigsten Geschäftsprozesse ist vorbereitet.
- Die Wiederherstellung wurde in den letzten zwölf Monaten getestet, die Zielwerte wurden erreicht.
- Der Plan wurde nach der letzten größeren Änderung der IT aktualisiert.
Typische Fehler
Backup mit Disaster Recovery verwechseln
Eine Sicherung zu haben heißt nicht, in vertretbarer Zeit wiederherstellen zu können. Ohne Plan, Reihenfolge und Test bleibt das Backup ein Datenhaufen.
Abhängigkeiten übersehen
Das wiederhergestellte System startet nicht, weil Verzeichnisdienst, Lizenzserver oder eine Schnittstelle fehlen.
Nie getestet
Ohne Test weiß niemand, ob die Wiederherstellungszeiten realistisch sind. Erfahrungsgemäß dauert der erste Test deutlich länger als geplant.
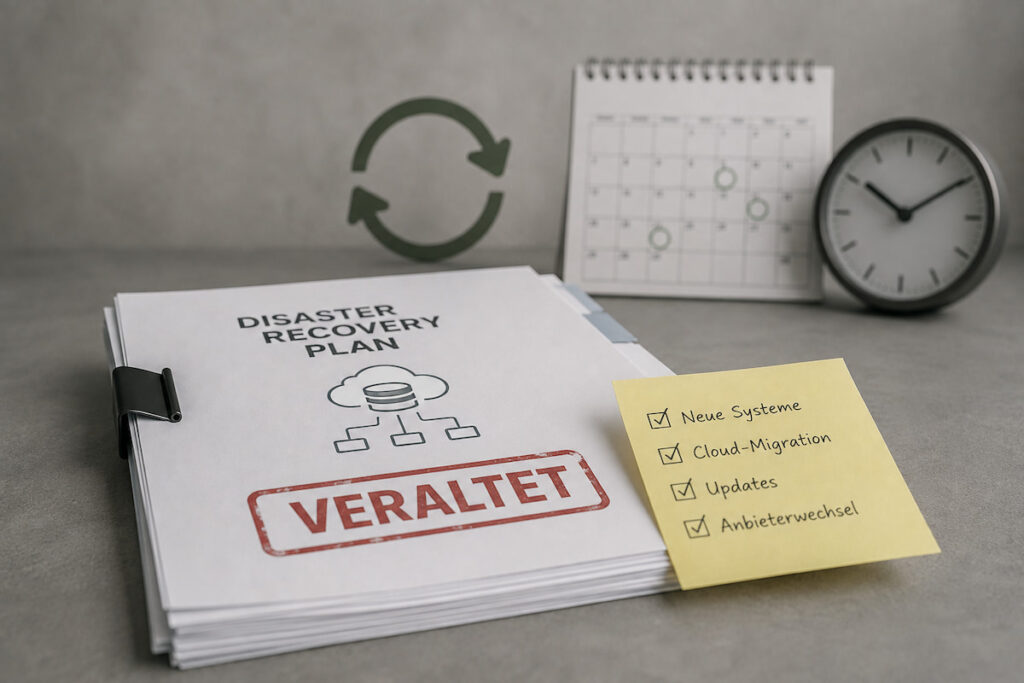
Plan veraltet
Neue Systeme, neue Dienstleister, ausgeschiedene Verantwortliche: Ein Plan, der nicht mindestens jährlich aktualisiert wird, führt im Ernstfall in die Irre.
Fazit: Disaster Recovery muss vor dem Ernstfall funktionieren
Disaster Recovery entscheidet darüber, ob ein schwerer IT-Ausfall ein ärgerlicher Tag oder eine existenzbedrohende Krise wird. Die Grundlage sind klare Zielwerte aus der Business Impact Analysis, eine passende Strategie für jedes kritische System, ein verständlicher Plan und regelmäßige Tests. Gegen Cyberangriffe kommen isolierte Sicherungen und eine saubere Wiederaufbauumgebung hinzu.
Sie möchten wissen, ob Ihre Disaster-Recovery-Planung im Ernstfall trägt? Mit unserem IT-Security-Audit zum Festpreis prüfen wir Backups, Wiederherstellungsfähigkeit und Notfallplanung. Bei einem akuten Vorfall unterstützt Sie unsere Incident Response. Oder vereinbaren Sie direkt ein kostenloses Erstgespräch.
Quellen
- Bundesamt für Sicherheit in der Informationstechnik: BSI-Standard 200-4 Business Continuity Management
- Bundesamt für Sicherheit in der Informationstechnik: BSI-Standard 200-4 verhilft mit Business Continuity Management zu ganzheitlicher Resilienz
- § 30 BSI-Gesetz, Risikomanagementmaßnahmen
- Verordnung (EU) 2016/679 (DSGVO), Art. 32















